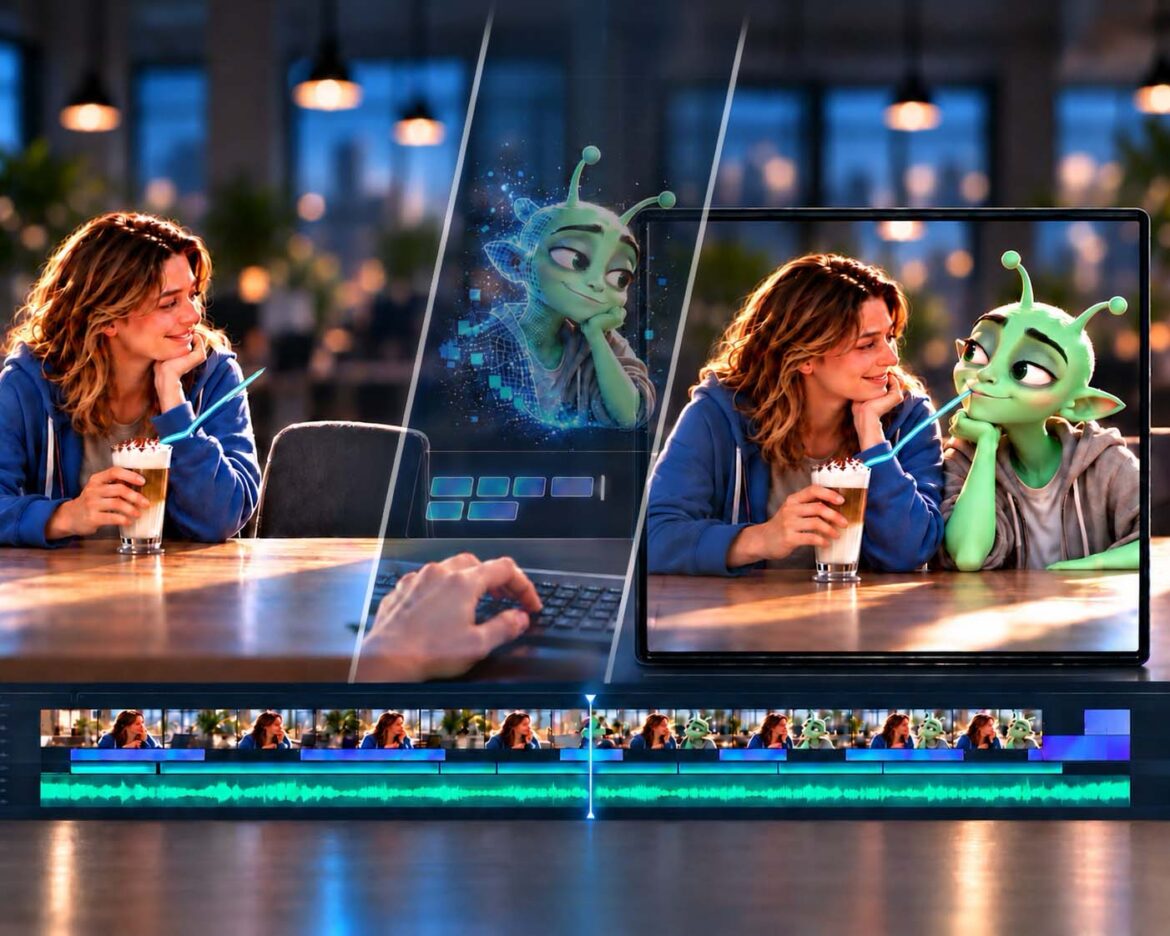
Eine reale Aufnahme erhält im Nachhinein eine KI-Figur, die erst nach dem Dreh in der Cloud entsteht.
Visualisierung: Vom Dreh über die Bearbeitung zum fertigen Bild, die Figur kommt erst in der Nachbearbeitung hinzu | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
KI-Compositing fügt computergenerierte Figuren nachträglich in reale Filmaufnahmen ein, und zwar so, dass Licht, Schatten und Perspektive zur gefilmten Umgebung passen. Die Ergebnisse sind inzwischen so überzeugend, dass viele Betrachter annehmen, die künstliche Intelligenz (KI) arbeite bereits in Echtzeit, also im selben Moment, in dem die Kamera läuft. Das ist der Punkt, an dem sich Produktion und Spatial Computing unterscheiden, also die Darstellung digitaler Inhalte, die sich live auf den realen Raum beziehen.[1]
Diese Unterscheidung ist für Unternehmen wichtig. Wer Werbefilme, Produktvideos oder Schulungsinhalte produziert, kann solche Werkzeuge schon heute nutzen. Wer dagegen Anwendungen für Spatial Computing plant, braucht eine ehrliche Einordnung, wie weit die Technik von der Echtzeit noch entfernt ist. Dieser Artikel liefert sie: Er erklärt, wie KI-Compositing funktioniert, stellt vier etablierte Werkzeuge vor, zeigt die technischen Hürden auf dem Weg zur Echtzeit und beschreibt, welche Entwicklungen die Lücke schließen könnten.
- Heutige KI-Compositing-Werkzeuge liefern fertige Filme, keine Echtzeit-Interaktion.
- Reality-Aware Rendering analysiert eine Aufnahme, nachdem die Kamera gestoppt hat.
- Vier Werkzeuge decken sehr unterschiedliche Arbeitsweisen, Preise und Qualifikationen ab.
- Echtzeit scheitert an Rechenleistung, Latenz und dem Verständnis der Szene.
- Wer heute Erfahrung aufbaut, nutzt das Zeitfenster bis zur nächsten Technikstufe.
Der Artikel führt in acht Schritten durch das Thema: von der Frage, was KI-Compositing von Echtzeit-AR trennt, über die Funktionsweise des Verfahrens, die vier wichtigsten Werkzeuge, die Grenzen der Echtzeit, die Chance durch Gaussian Splatting und den Chip-Fahrplan bis zu einem Beispielfilm und dem Zeitstrahl von der Nachbearbeitung zur Präsenz.
Was KI-Compositing von Echtzeit-AR trennt
Beim klassischen Compositing werden mehrere Bildebenen zu einem Film zusammengesetzt, etwa eine reale Aufnahme und eine computergenerierte Figur. KI übernimmt dabei immer mehr Teilschritte: die Bewegung der Figur, die passende Beleuchtung und die Anpassung an die Umgebung. Das spart Zeit und Kosten gegenüber aufwendigen Effektproduktionen, den sogenannten VFX-Abläufen.
Von Echtzeit-AR spricht man dagegen, wenn digitale Inhalte in dem Moment erzeugt und dargestellt werden, in dem der Mensch sich bewegt und die Umgebung wahrnimmt. Das verlangt, dass Wahrnehmung und Reaktion gleichzeitig stattfinden. Genau das ist das große Versprechen des Spatial Computing: digitale Inhalte, die ihre physische Umgebung verstehen und auf sie antworten.
Ob ein Werkzeug heute schon dieses Versprechen einlöst, entscheidet darüber, wie Produktionsteams, Marketingabteilungen und Fachleute für Spatial Computing es bewerten sollten. Ein Werkzeug für die Filmproduktion bewertet man nach Bildqualität, Kosten und Arbeitszeit. Eine Plattform für Echtzeit-Erlebnisse bewertet man nach Reaktionszeit, Zuverlässigkeit und Hardware. Beide Maßstäbe führen zu völlig verschiedenen Entscheidungen.
Das Bild veranschaulicht den Kern des Unterschieds. Auf der linken Seite steht die Aufnahme: Eine Frau sitzt mit einem Milchkaffee an einem Tisch und blickt zur Seite, der Platz neben ihr ist leer. Auf der rechten Seite steht das fertige Ergebnis: Dort sitzt eine freundliche grüne Figur neben ihr und trinkt aus ihrem Strohhalm. Zwischen beiden liegt ein Verarbeitungsschritt in der Cloud.
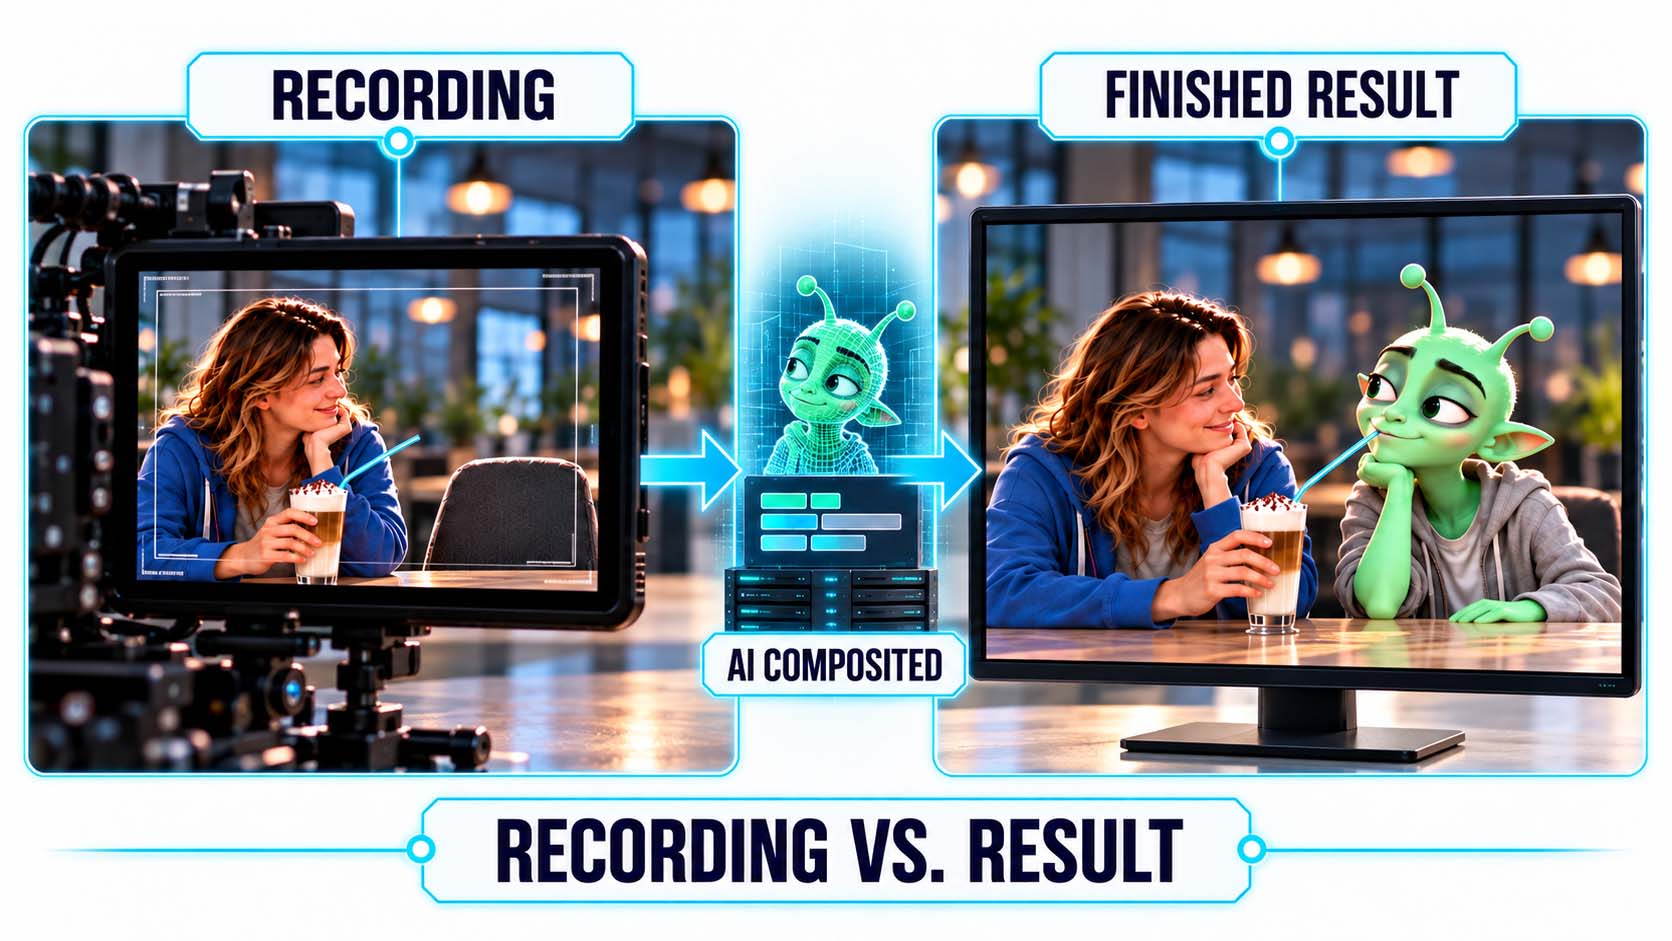
Zwischen Aufnahme und fertigem Bild liegt ein Verarbeitungsschritt, in dem die Figur erst entsteht.
Infografik: Die Figur ist beim Dreh nicht vorhanden und wird erst nach der Aufnahme in der Cloud hinzugefügt[1] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
Wer ein solches Ergebnis bewertet, sollte deshalb zwei Fragen trennen. Die erste lautet: Wie gut ist das Bild? Die Antwort ist eindrucksvoll. Die zweite lautet: Wann ist es entstanden? Die Antwort lautet: danach. Beide Fragen sind berechtigt, sie führen aber zu unterschiedlichen Schlüssen für die eigene Planung.
- KI-Compositing setzt reale Aufnahmen und computergenerierte Figuren zu einem Film zusammen.
- Echtzeit-AR verlangt, dass Wahrnehmung und Reaktion im selben Moment stattfinden.
- Ein Produktionswerkzeug und eine Echtzeit-Plattform haben verschiedene Bewertungsmaßstäbe.[1]
- Bei heutigen Werkzeugen entsteht die Figur nach der Aufnahme, nicht während des Drehs.
- Die Einordnung entscheidet, ob ein Werkzeug heute oder erst in einigen Jahren zur eigenen Aufgabe passt.
Wie das Verfahren im Einzelnen abläuft, zeigt das nächste Kapitel.
Was Reality-Aware Rendering tatsächlich leistet
Reality-Aware Rendering, wie es das Werkzeug Simulon einsetzt, ist eine Nachbearbeitung in der Cloud. Der Ablauf hat mehrere Stationen. Zuerst entsteht das Konzept: Die Kreativen legen fest, welche Szene gezeigt wird, welche Requisiten vorkommen und wie die Figur mit der Umgebung interagiert. Danach scannt eine iPhone-App den Raum rundum und erzeugt daraus ein Lichtmodell, mit dem später die Beleuchtung der echten Umgebung nachgebildet werden kann.[1]
Dann folgt die Aufnahme. Die Darstellerin oder der Darsteller spielt die geplanten Interaktionen, die Kamera zeichnet die sogenannte Plate auf, also das reale Filmmaterial, in das die Figur später eingefügt wird. Diese Aufnahme wird zusammen mit dem Szenenscan und einem Prompt hochgeladen, also einer kurzen Textanweisung, die beschreibt, was die Figur tun soll, etwa eine freundliche grüne Figur, die aus dem Strohhalm trinkt. In der Cloud analysiert die KI Bewegung, Sprache und Licht und erzeugt daraus eine neue Figurendarstellung. Wenige Minuten später liegt der fertige, zusammengesetzte Film vor.[1]
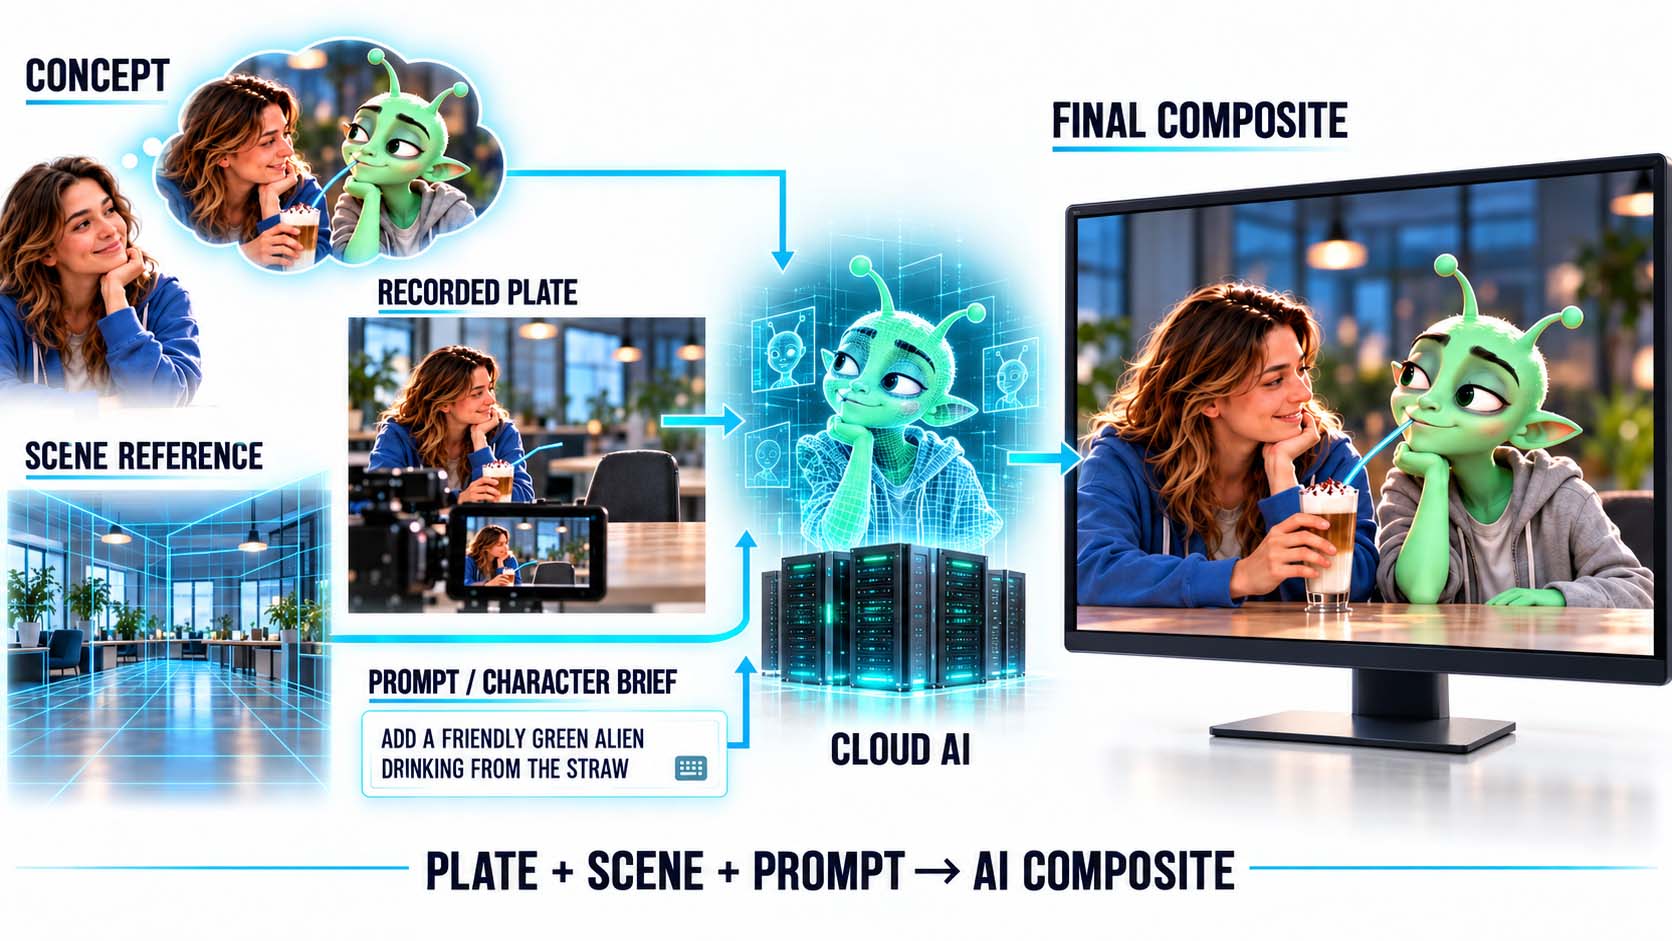
Drei Eingaben, Aufnahme, Szenenreferenz und Textanweisung, ergeben in der Cloud einen fertigen Film.
Infografik: Aufnahme, Szenenscan und Prompt fließen in die Cloud-KI, das fertige Bild entsteht erst danach[1] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
Die Figur nimmt die reale Welt dabei nicht selbst wahr. Sie entsteht aus der Analyse einer Aufnahme der realen Welt, die erst vorliegt, nachdem die Kamera gestoppt hat. Der Begriff Reality-Aware ist im engen Sinn zutreffend: Das System wird von der Realität informiert. Es verarbeitet diese Information aber zeitversetzt und nicht gleichzeitig.
Für die Praxis ist das keine Schwäche, sondern eine Eigenschaft. Ein zeitversetzter Ablauf erlaubt es, Aufnahmen sorgfältig zu planen, Varianten zu rechnen und Ergebnisse zu prüfen, bevor sie veröffentlicht werden. Für Anwendungen, in denen ein Mensch live mit der Figur interagieren soll, reicht er dagegen nicht aus.
- Reality-Aware Rendering ist eine Cloud-Nachbearbeitung mit mehreren Stationen von der Planung bis zum fertigen Film.[1]
- Ein iPhone-Scan erzeugt ein Lichtmodell des realen Raums.[1]
- Die KI analysiert Aufnahme, Bewegung, Sprache und Licht und erzeugt daraus die Figurendarstellung.[1]
- Die Figur reagiert auf eine Analyse der Aufnahme, nicht auf die Realität im Moment des Drehs.
- Das System ist informiert von der Realität, verarbeitet sie aber zeitversetzt.
Simulon ist nicht das einzige Werkzeug dieser Art. Welche weiteren Ansätze es gibt, zeigt das nächste Kapitel.
Vier Werkzeuge, vier Arbeitsweisen
Neben Simulon prägen vier Werkzeuge das heutige Feld des KI-gestützten 3D-Character-Compositings. Sie unterscheiden sich in Arbeitsweise, Preis und benötigten Fähigkeiten.
Autodesk Flow Studio arbeitet als Komplettlösung im Browser: Ein Video wird hochgeladen, mehrere KI-Modelle laufen parallel, und am Ende steht ein zusammengesetztes Bild oder eine Ausgabe für Maya, Blender oder Nuke.[2] Move.ai ersetzt die klassische Bewegungserfassung mit Spezialanzügen und Markern durch Analyse normaler Videos und liefert Bewegungsdaten für 3D-Künstler.[3] MetaHuman Animator in der Unreal Engine 5 überträgt Gesichts- und Körperbewegung von iPhone oder Webcam auf eine hochdetaillierte digitale Figur und gilt als besonders fotorealistisch.[4] Adobe Firefly Video ergänzt den Schnitt in Premiere Pro um KI-generiertes Zusatzmaterial, verlängerte Einstellungen sowie das Hinzufügen und Entfernen von Objekten.[5]
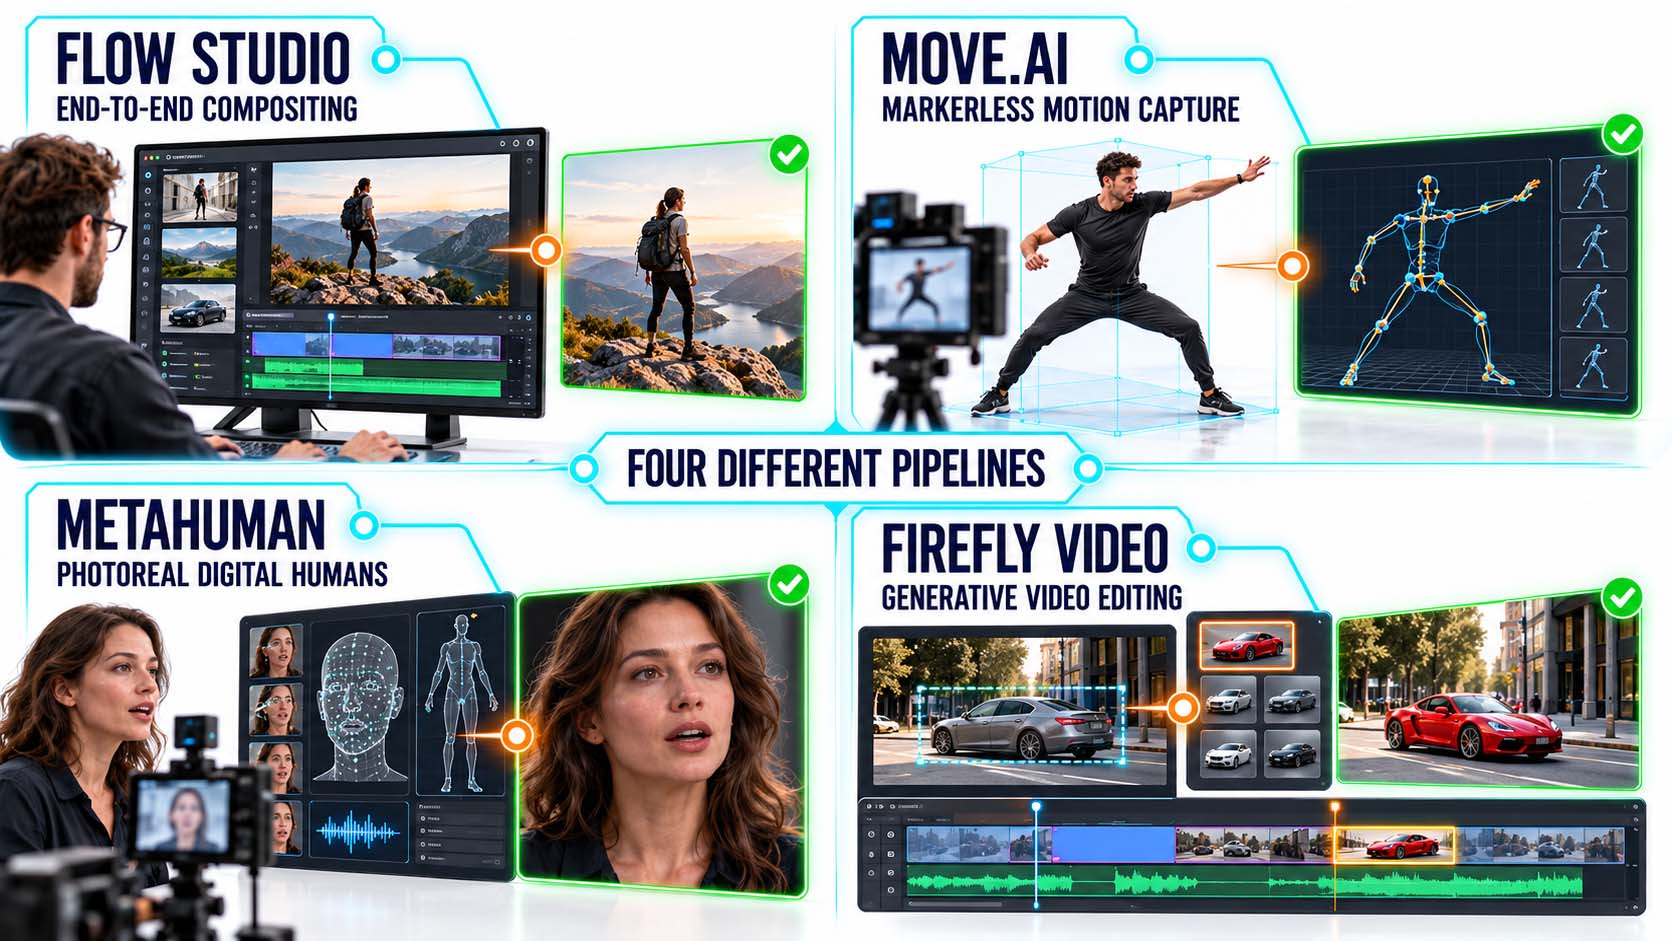
Vier Werkzeuge lösen vier unterschiedliche Aufgaben, sie sind keine austauschbaren Alternativen.
Infografik: Gesamtablauf, Bewegungserfassung, digitale Menschen und Videoschnitt als vier eigenständige Pipelines[2][3][4][5] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
| Werkzeug | Arbeitsweise | Gut geeignet für | Preis laut Hersteller |
|---|---|---|---|
| Autodesk Flow Studio | Browser-Upload, 25 parallele KI-Modelle, zusammengesetzte Ausgabe oder Export für Maya, Blender, Nuke | Komplettes Compositing ohne eigenes VFX-Team | Kostenlos (720p) bis 95 USD pro Monat |
| Move.ai | Video-Upload, markerlose Bewegungserfassung, Export als FBX oder USD | Studios mit 3D-Künstlern, die physische Bewegungserfassung ersetzen wollen | Ab 50 USD pro Monat |
| MetaHuman Animator (Unreal Engine 5) | iPhone oder Webcam, Gesichts- und Körperanimation auf MetaHuman-Figur, Compositing in UE5 | Höchster Fotorealismus, Studios unter 1 Million USD Umsatz | Kostenlos bzw. 1.850 USD pro Arbeitsplatz und Jahr |
| Adobe Firefly Video | KI-B-Roll, Generative Extend, Objekte hinzufügen oder entfernen in Premiere Pro | Marketing- und Redaktionsteams im Adobe-Umfeld | In Creative Cloud enthalten, ab ca. 55 USD pro Monat |
Jedes Werkzeug beginnt an einer anderen Stelle der Produktionskette.
Tabelle: Vier Werkzeuge im Überblick, Herstellerangaben, Preise können sich geändert haben und sind vor einer Buchung zu prüfen[2][3][4][5] | XR Stager Online Magazin | VISORIC GmbH
Eine Gemeinsamkeit gilt für alle vier: Keines ist ein Echtzeitsystem. Alle verarbeiten Filmmaterial nach der Aufnahme, die Wartezeit in der Cloud reicht von Sekunden bis Minuten. Adobe Firefly Video kommt einer sofortigen Rückmeldung am nächsten, erzeugt aber Zusatzmaterial und Verlängerungen, keine individuellen fotorealistischen Figuren, die mit einer Szene interagieren.
- Flow Studio liefert eine Komplettlösung im Browser für Compositing ohne VFX-Team.[2]
- Move.ai ersetzt Bewegungserfassung mit Spezialanzügen durch die Analyse normaler Videos.[3]
- MetaHuman Animator bietet den höchsten Fotorealismus, braucht aber Kenntnisse der Unreal Engine.[4]
- Firefly Video unterstützt den Schnitt in Premiere Pro mit KI-Material.[5]
- Keines der vier Werkzeuge arbeitet in Echtzeit.
Warum Echtzeit eine so viel größere Hürde ist als schnelleres Rendern, zeigt das nächste Kapitel.
Warum Echtzeit heute noch nicht funktioniert
Die Hindernisse auf dem Weg zu einer KI-Figur in Echtzeit sind grundsätzlicher Natur, nicht eine Frage kleiner Verbesserungen. Drei Probleme müssen gleichzeitig gelöst werden, und jedes ist für sich anspruchsvoll.
Das erste ist die Rechenlücke. Ein aktuelles Smartphone-Flaggschiff liefert nach den Angaben der Quellen rund 3,8 TFLOPS Grafikleistung (Adreno 750), eine Desktop-Grafikkarte wie die RTX 4090 etwa 165 TFLOPS. TFLOPS steht für Billionen Rechenoperationen pro Sekunde. Das entspricht einem Faktor von etwa 30 bis 40. Die Lücke ist ein physikalisches Problem, kein Softwareproblem. Die neuronalen Prozessoren im Smartphone, kurz NPUs, erreichen zwar 35 bis 100 TOPS, sind aber für das Auswerten von KI-Modellen ausgelegt, nicht für fotorealistisches Rendern. Hinzu kommt die Hitze: In Benchmarks sank die Bildrate nach zehn Minuten Dauerlast um rund 40 Prozent.[6]
Das zweite Problem ist die Latenz, also die Verzögerung. Für AR gilt eine Zielvorgabe von 7 bis 15 Millisekunden zwischen Kopfbewegung und angezeigtem Bild, die sogenannte Motion-to-Photon-Latenz.[9] Ein Weg vom Smartphone in ein Rechenzentrum und zurück dauert allein im Netzwerk mindestens 50 bis 200 Millisekunden, mit KI-Berechnung kommen 300 Millisekunden bis zwei Sekunden hinzu. Selbst wenn Mobile Edge Computing, also Rechenzentren nahe am Funkmast, die Netzwerkzeit unter 10 Millisekunden drückt, ist das Zeitbudget für ein Bild verbraucht, bevor die KI zu rechnen beginnt. NVIDIA beschreibt sein CloudXR-System ab 150 Millisekunden Einwegverzögerung als unbrauchbar.[8]
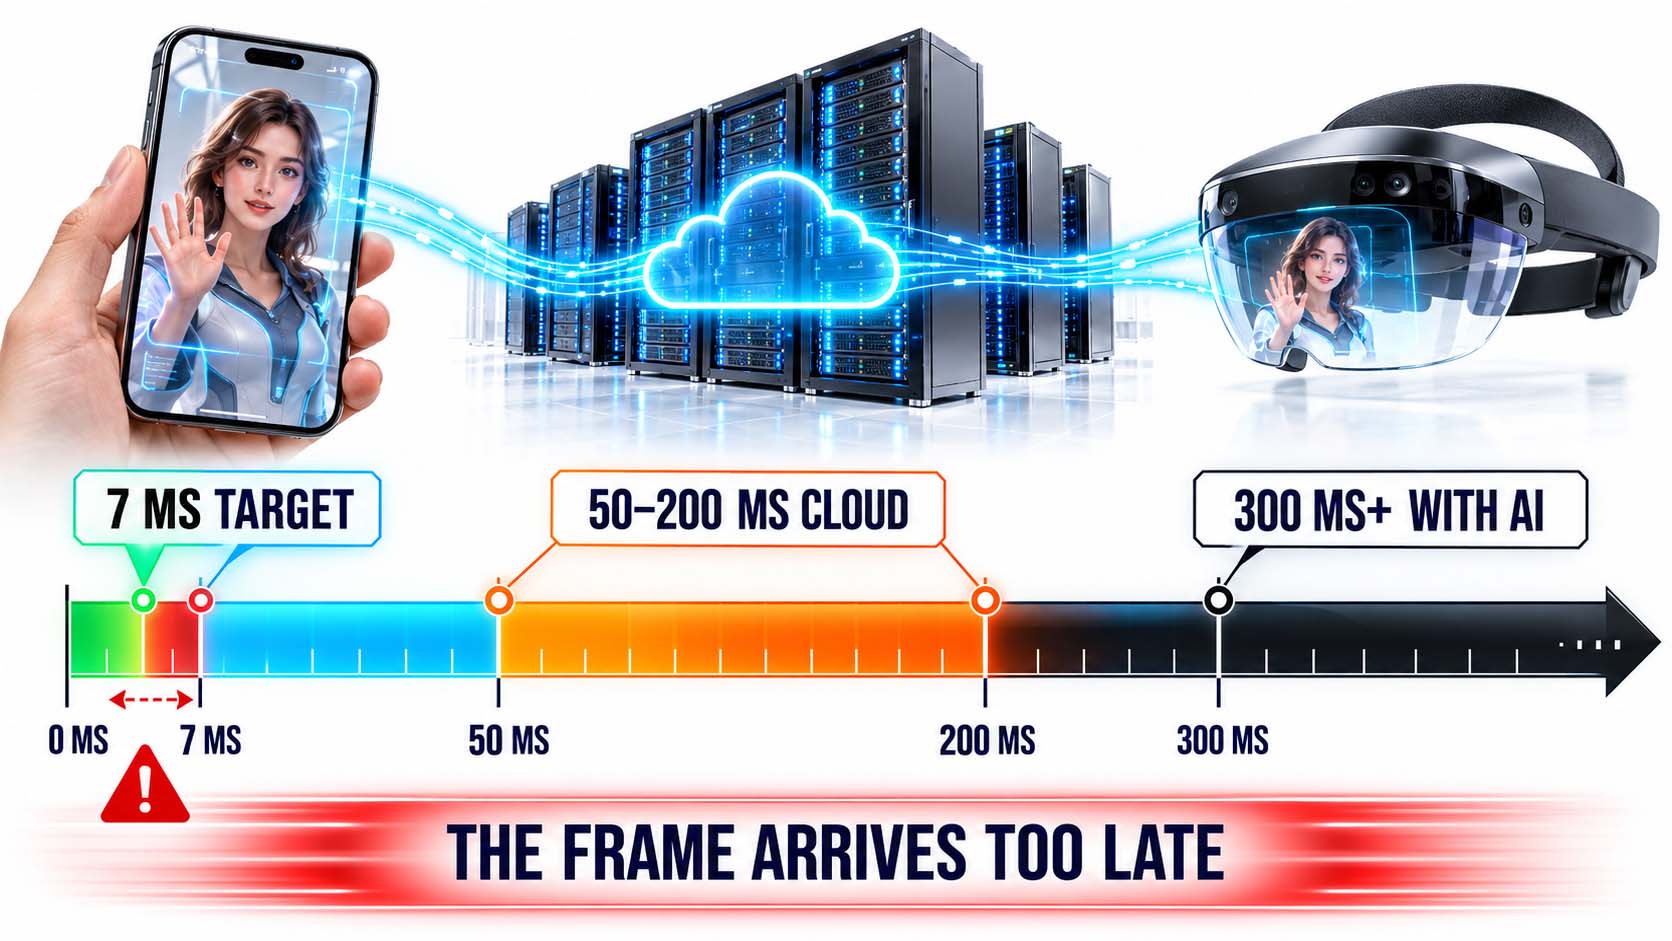
Das Bild kommt zu spät an, weil schon die Cloud-Strecke das Zeitbudget von wenigen Millisekunden sprengt.
Infografik: Zielwert für AR von 7 Millisekunden im Vergleich zur Cloud-Laufzeit und zur Laufzeit mit KI-Berechnung[8][9] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
| Messgröße | Wert | Bedeutung |
|---|---|---|
| Zielwert für AR (Motion-to-Photon) | 7 bis 15 ms | Grenze, ab der das Bild als verzögert wahrgenommen wird |
| Cloud-Strecke im Netzwerk | 50 bis 200 ms | Mindestdauer allein für Hin- und Rückweg |
| Cloud-Strecke mit KI-Berechnung | 300 ms bis 2 s | Ein Vielfaches des zulässigen Zeitbudgets |
| Unbrauchbarkeitsgrenze bei CloudXR | 150 ms Einwegverzögerung | Herstellerangabe von NVIDIA |
| Rechenlücke Smartphone zu Desktop | Faktor 30 bis 40 | Rund 3,8 gegenüber 165 TFLOPS |
| Leistungsabfall durch Hitze | Rund 40 % nach 10 Minuten | Benchmark unter Dauerlast |
Schon die Netzwerkzeit allein ist ein Vielfaches des zulässigen Zeitbudgets.
Tabelle: Zeit- und Leistungswerte zur Echtzeitfähigkeit, Angaben der genannten Quellen[6][8][9] | XR Stager Online Magazin | VISORIC GmbH
Das dritte Problem ist das Szenenverständnis. Eine fotorealistische Figur, die korrekt auf ihre Umgebung reagiert, setzt voraus, dass das System Geometrie, Licht, Physik und menschliche Absicht gleichzeitig versteht. Heutige Systeme analysieren Aufnahmen im Nachhinein. Die dynamische Neubeleuchtung einer Figur in Echtzeit, wenn sich das Licht ändert, gilt derzeit als das schwierigste ungelöste Problem des Feldes, schwieriger noch als die verfügbare Rechenleistung.
- Smartphone-Grafik liegt etwa um den Faktor 30 bis 40 hinter Desktop-Hardware.[6]
- AR verlangt 7 bis 15 Millisekunden, die Cloud-Strecke braucht allein im Netz 50 bis 200 Millisekunden.[8][9]
- Mit KI-Berechnung steigt die Laufzeit auf 300 Millisekunden bis zwei Sekunden.
- Hitze senkt die Dauerleistung von Smartphones deutlich.[6]
- Dynamische Neubeleuchtung in Echtzeit ist das schwierigste ungelöste Teilproblem.
Eine Technik, die einen Teil dieser Hürden bereits überwindet, ist Gaussian Splatting. Sie steht im Mittelpunkt des nächsten Kapitels.
Was Gaussian Splatting verändert
Gaussian Splatting gilt als wichtigste jüngere Entwicklung im Echtzeit-3D-Rendering, und sie läuft bereits auf Mobilgeräten. Die Technik beschreibt eine 3D-Szene nicht mit Dreiecksflächen, sondern mit Millionen halbtransparenter Ellipsoide, den sogenannten Splats. Aus diesen lassen sich sehr schnell neue Ansichten aus beliebigen Blickwinkeln berechnen.[7]
Dass dies auf Mobilgeräten funktioniert, zeigt die Arbeit Mobile-GS auf der Konferenz CVPR 2025: Sie erreichte 116 Bilder pro Sekunde auf einem Gerät mit Snapdragon 8 Gen 3 und nach thermischem Gleichgewicht, also nach einer Phase der Erwärmung, noch 74 Bilder pro Sekunde.[6] Zum Vergleich: Flüssige Darstellung beginnt bei etwa 60 Bildern pro Sekunde.
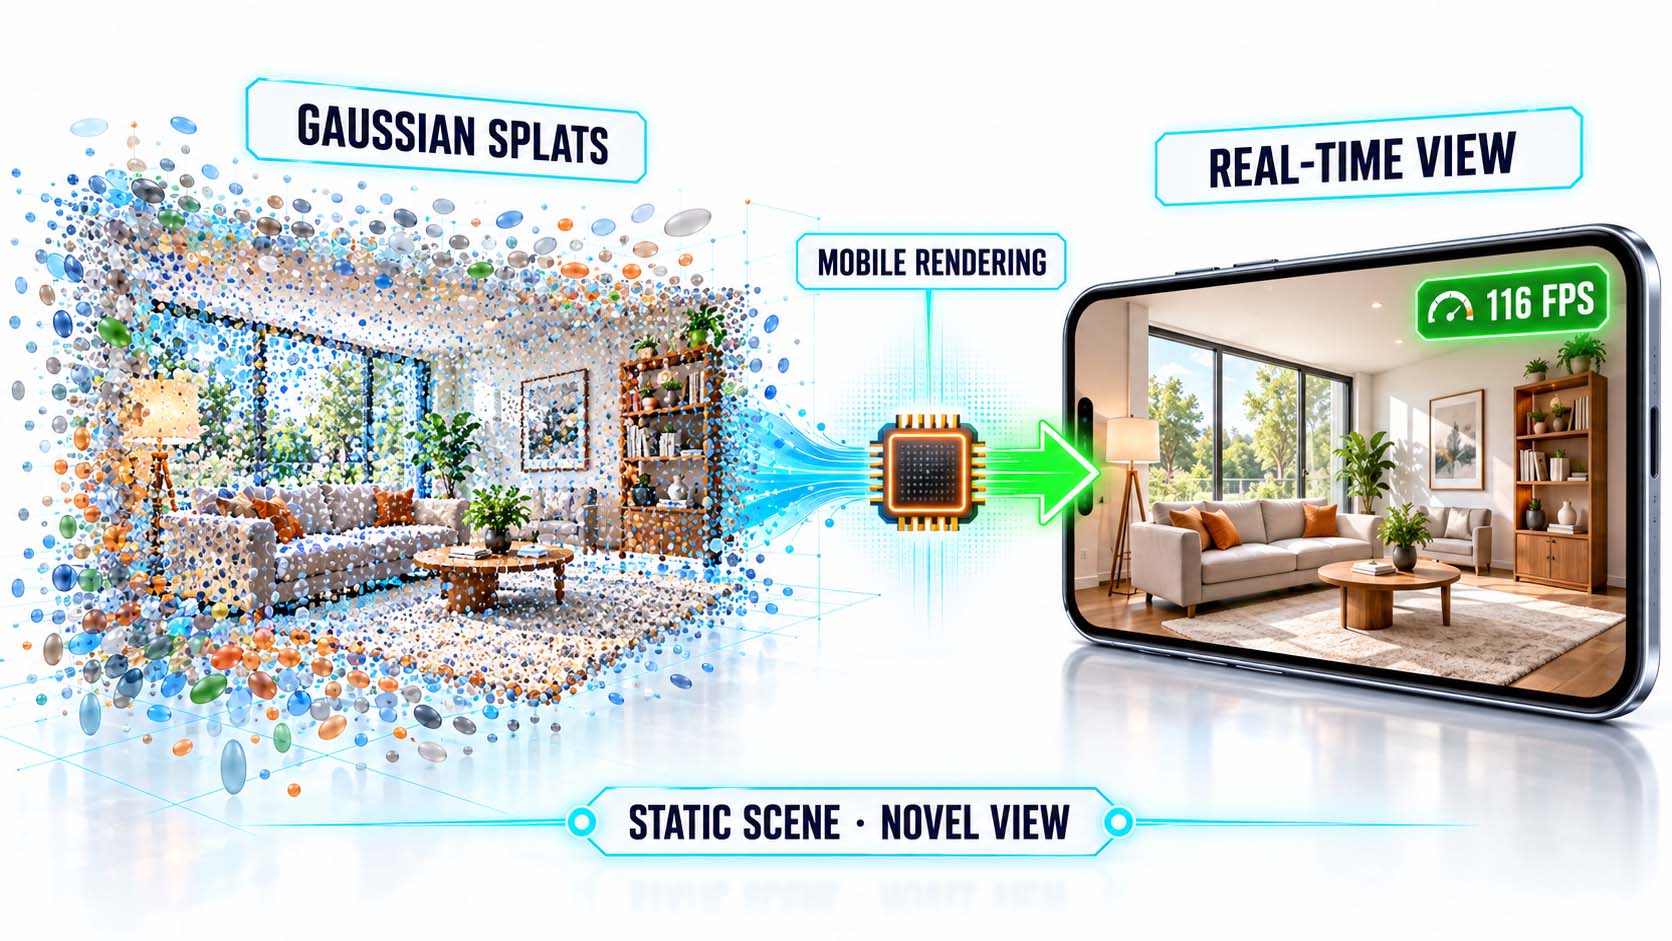
Eine einmal erfasste, feststehende Szene lässt sich auf dem Smartphone flüssig aus jedem Blickwinkel betrachten.
Infografik: Aus Millionen Splats wird auf dem Mobilgerät eine Echtzeitansicht einer statischen Szene mit 116 Bildern pro Sekunde[6][7] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
Die entscheidende Einschränkung lautet: Gaussian Splatting beherrscht derzeit statische, vorab trainierte Szenen. Ein Raum, eine Landschaft oder ein Gebäudeinneres lässt sich scannen, zu einem Splat-Modell trainieren und anschließend in Echtzeit aus jedem Winkel ansehen. Vollkörper-Figuren, die sich animieren lassen und in fotorealistischer Qualität per Gaussian Splatting dargestellt werden, laufen nach allen veröffentlichten Forschungsarbeiten bis 2026 nur auf Desktop-Rechnern. Die Lücke zwischen der Darstellung statischer Szenen und der Erzeugung dynamischer Figuren ist die nächste Grenze.
- Gaussian Splatting beschreibt Szenen mit Millionen halbtransparenter Ellipsoide statt mit Polygonen.[7]
- Mobile-GS erreichte 116 Bilder pro Sekunde auf einem Snapdragon 8 Gen 3.[6]
- Nach thermischem Gleichgewicht blieben 74 Bilder pro Sekunde.[6]
- Die Technik beherrscht feststehende Szenen, keine frei bewegten, generativen Figuren.
- Animierbare Vollkörper-Figuren in dieser Qualität laufen bisher nur auf dem Desktop.
Ob und wann Chips und Modelle diese Lücke schließen, hängt vom Hardware-Fahrplan ab. Das zeigt das nächste Kapitel.
Chips und kleinere Modelle als Fahrplan
Die Leistungskurve der Rechenchips steigt steil. Als Maß dient TOPS, Billionen Rechenoperationen pro Sekunde für KI-Aufgaben. Apples M4 liefert 38 TOPS für neuronale Verarbeitung. Für den M5 wird ein Wert von rund 133 TOPS genannt, dahinter steht ein neuer Aufbau mit Beschleunigern für KI direkt in jedem Grafikkern, sodass KI-Berechnung parallel zum Rendern läuft.[10] Qualcomms Snapdragon X Elite erreicht 45 TOPS über die NPU, die des 8 Elite Gen 5 soll laut Berichten 37 Prozent schneller sein als beim Vorgänger von 2024.[11] Die Werte für den M5 sind Herstellerangaben beziehungsweise Projektionen und sollten vor einer Planung geprüft werden.
Parallel werden die KI-Modelle selbst kleiner. Die sogenannte INT4-Quantisierung speichert die Gewichte eines Modells mit weniger Genauigkeit und erreicht damit vier- bis dreizehnfach schnellere Ausgabe bei fünf- bis sechsfach kleinerer Modellgröße und geringem Qualitätsverlust. Metas Verfahren SqueezeMe stellt drei fotorealistische Vollkörper-Avatare gleichzeitig mit 72 Bildern pro Sekunde auf der Meta Quest 3 dar. Das ist bereits Echtzeit, allerdings für vorab erfasste Figuren.[13]
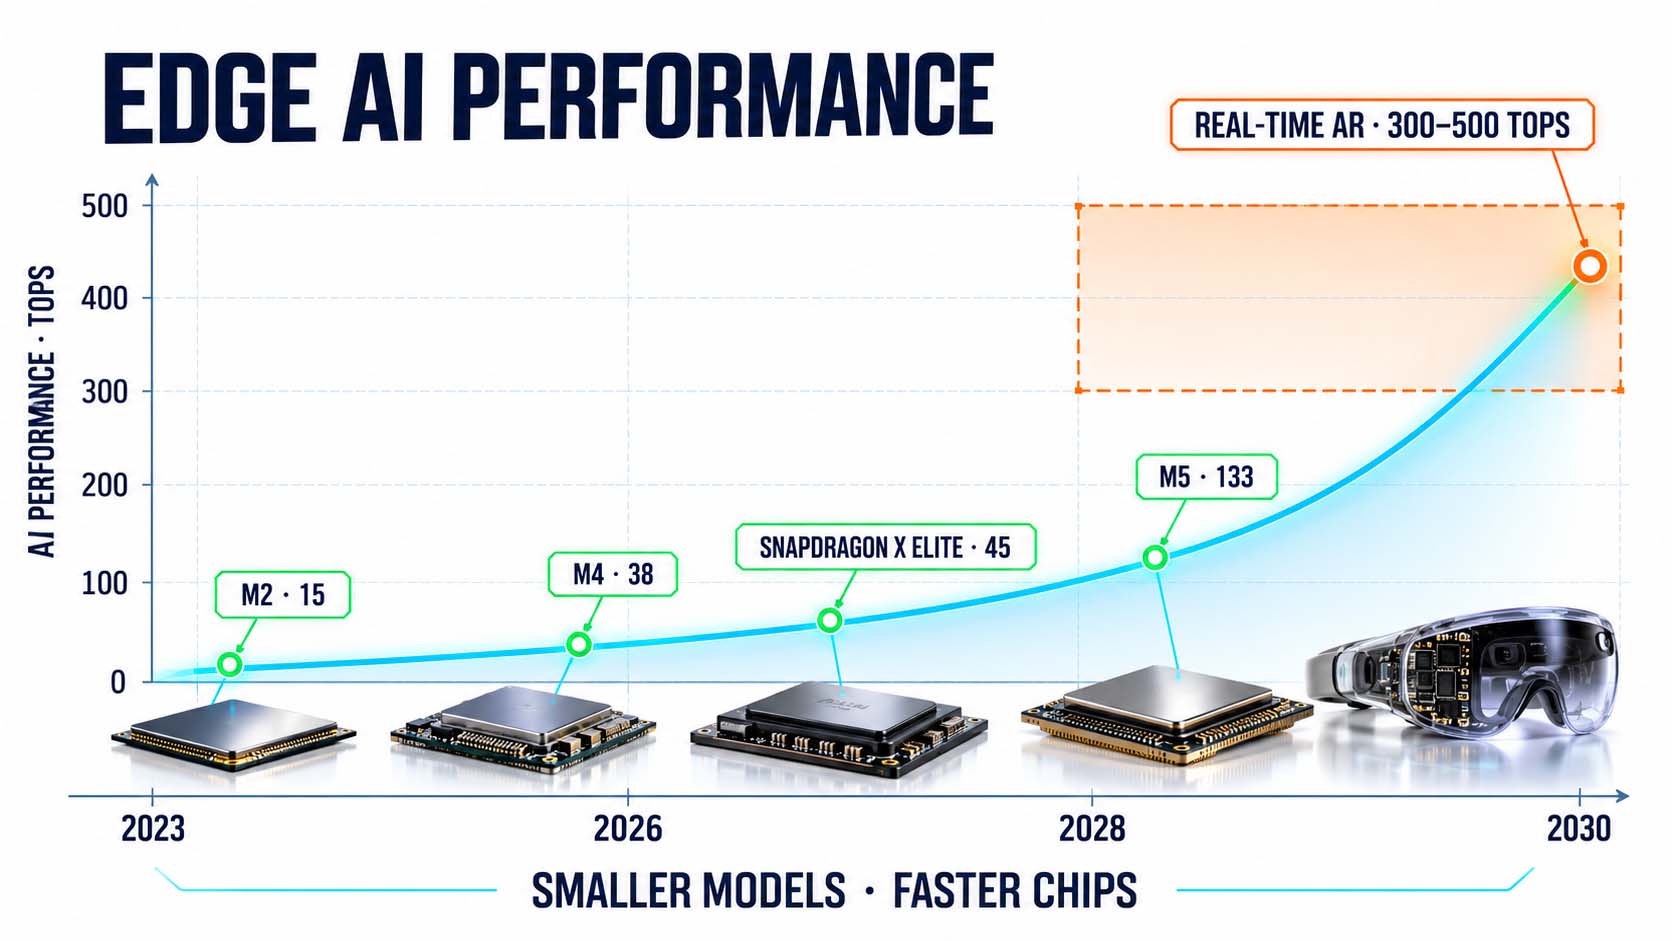
Die Kurve steigt steil, die Schwelle für generative Echtzeit-Figuren liegt aber noch weit darüber.
Infografik: KI-Leistung aktueller Chips im Vergleich zur geschätzten Schwelle für generative Echtzeit-AR, Jahreszahlen der Achse sind grobe Orientierung[10][11] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
| Chip oder Schwelle | KI-Leistung | Einordnung |
|---|---|---|
| Apple M2 | 15 TOPS | Ausgangspunkt der Kurve |
| Apple M4 | 38 TOPS | Herstellerangabe |
| Qualcomm Snapdragon X Elite | 45 TOPS | Herstellerangabe zur NPU |
| Apple M5 | Rund 133 TOPS | Genannter Wert, als Projektion einzuordnen |
| Generative Echtzeit-AR | 300 bis 500 TOPS | Geschätzte Schwelle auf dem Gerät |
Die geschätzte Schwelle für generative Echtzeit-Figuren liegt etwa das Zwei- bis Vierfache über dem höchsten genannten Chipwert.
Tabelle: KI-Leistung ausgewählter Chips im Vergleich zur geschätzten Echtzeit-Schwelle, Herstellerangaben und Schätzungen[10][11] | XR Stager Online Magazin | VISORIC GmbH
Vollständig generative KI-Figuren mit dynamischer Neubeleuchtung, das schwierigere Problem, erfordern nach heutigen Schätzungen 300 bis 500 TOPS direkt auf dem Gerät. Forschende erwarten diese Schwelle im Zeitraum 2028 bis 2030, allerdings nur unter Bedingungen: Es braucht komprimierte 3D-Diffusionsmodelle und eine gelöste Echtzeit-Neubeleuchtung.
- Apples M4 erreicht 38 TOPS, für den M5 wird ein Wert von rund 133 TOPS genannt.[10]
- Snapdragon X Elite liefert 45 TOPS über die NPU.[11]
- INT4-Quantisierung macht Modelle bis zu sechsmal kleiner bei geringem Qualitätsverlust.
- SqueezeMe zeigt drei vorab erfasste Avatare mit 72 Bildern pro Sekunde auf der Quest 3.[13]
- Generative Echtzeit-Figuren brauchen geschätzt 300 bis 500 TOPS, erwartet für 2028 bis 2030.
Wie sich die heutige Technik an einem konkreten Beispielfilm zeigt und was dem fertigen Film nicht anzusehen ist, zeigt das folgende Kapitel.
Was ein fertiger KI-Film nicht zeigt
Ein Demonstrationsfilm auf LinkedIn zeigt, was aktuelle KI-Compositing-Werkzeuge im besten Fall liefern. Ein Neandertaler bewegt sich durch reale Umgebungen: Er lehnt an einem modernen Auto, sitzt in einem Großraumbüro am Laptop und steht mit einem Speer in einer Berglandschaft. Das Licht passt sich jedem Ort an, Schatten fallen korrekt, Größe und Perspektive der Figur stimmen mit der Umgebung überein.[1][15]
Der Beitrag erreichte mit über 800 Likes und mehr als 100 Reposts große Resonanz, und viele Kommentare nahmen an, es handle sich um Echtzeit-AR.[14] Tatsächlich ist es ein nachbearbeiteter Film. Für Film, Werbung und Markeninhalte ist das trotzdem eine echte Senkung von Kosten und Zeitaufwand gegenüber klassischen VFX-Abläufen.
Im fertigen Film nicht sichtbar sind die Schritte davor und danach. Das Bild zeigt sie in drei Stufen: Zuerst entsteht eine Skizze der Szene (Planned), dann nimmt eine Person die Szene mit dem Smartphone auf (Recorded), und erst danach berechnet die Cloud den fertigen Film (Rendered).
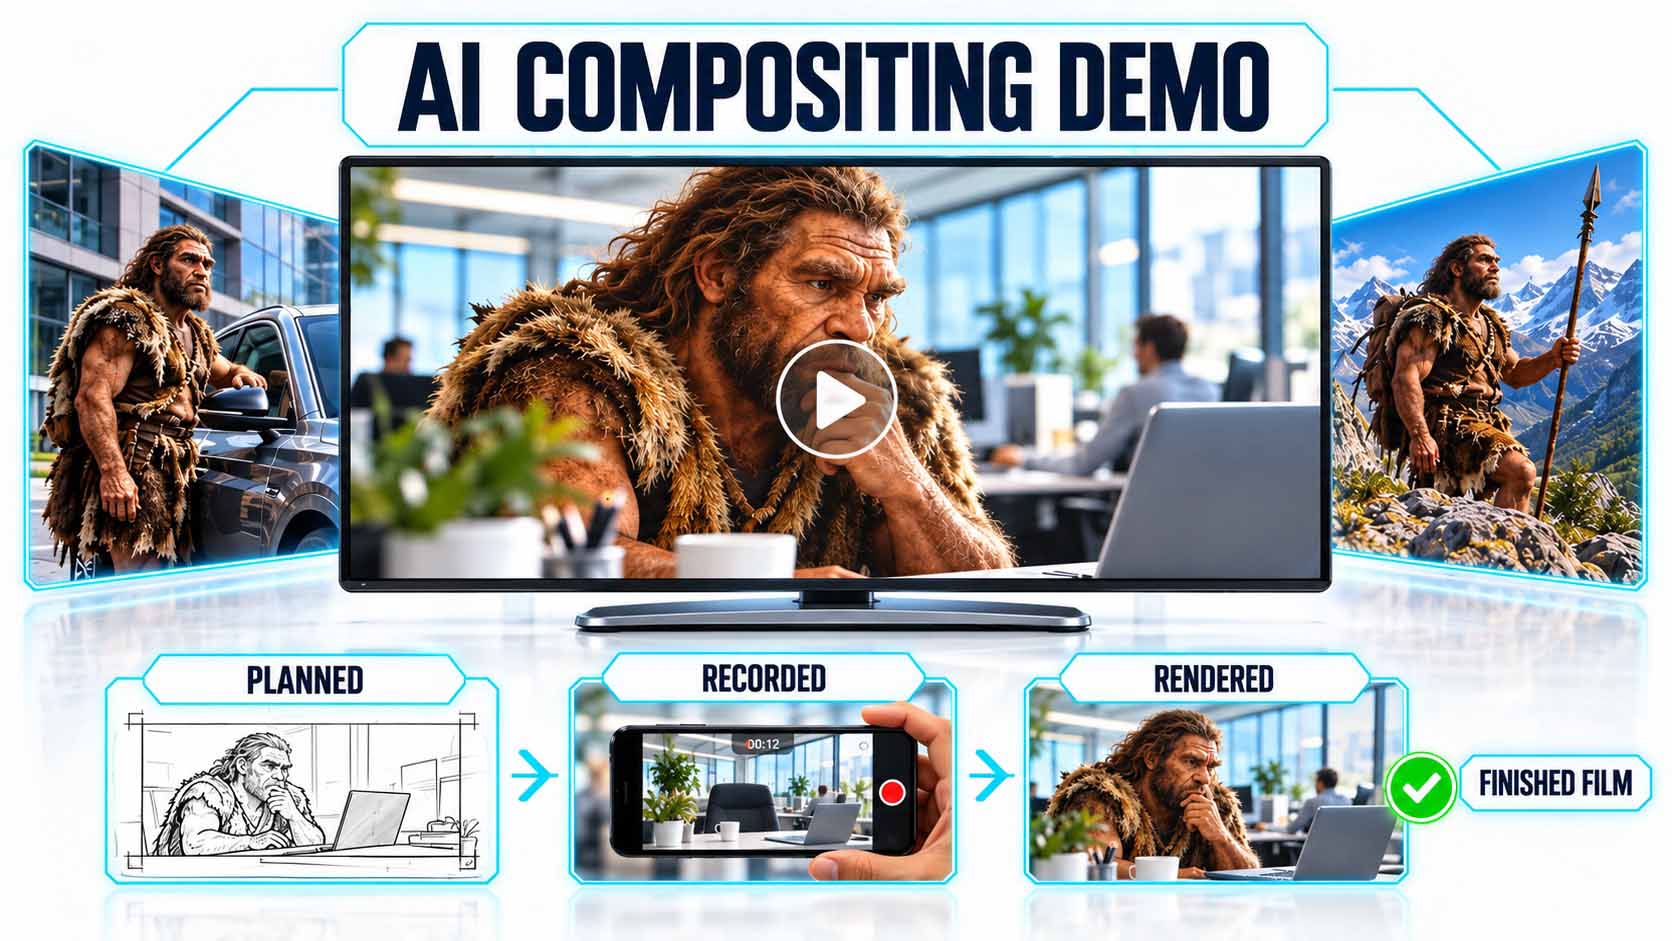
Der fertige Film entsteht in drei getrennten Schritten, nur der letzte ist im Ergebnis sichtbar.
Infografik: Von der Skizze über die Smartphone-Aufnahme zum berechneten Film, die Schritte laufen nacheinander und nicht gleichzeitig[1][15] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
Die Nahtlosigkeit des Ergebnisses verdeckt den zeitversetzten Charakter des Prozesses. Wer das Beispiel beurteilt, unterscheidet deshalb zwei Rollen: Als Produktionswerkzeug überzeugt die Technik schon heute. Als Plattform für Spatial Computing, die in Echtzeit auf den realen Raum reagiert, ist sie noch nicht so weit.
- Der Demonstrationsfilm zeigt einen Neandertaler in Büro, Straße und Berglandschaft mit passendem Licht und Schatten.[15]
- Hinter dem fertigen Film liegen Planung, Smartphone-Aufnahme und Cloud-Berechnung.[1]
- Für Film, Werbung und Markeninhalte senkt das Verfahren Kosten und Zeit gegenüber klassischen VFX-Abläufen.
- Viele Betrachter hielten das Ergebnis für Echtzeit-AR, es ist aber ein nachbearbeiteter Film.[14]
- Als Produktionswerkzeug überzeugend, als Echtzeit-Plattform noch nicht.
Wie der Weg von der Nachbearbeitung zur Echtzeit-Präsenz aussehen könnte, zeigt das nächste Kapitel.
Von der Nachbearbeitung zur Präsenz
Der Weg von den heutigen Compositing-Werkzeugen zu echter räumlicher Echtzeit-AR folgt einer nachvollziehbaren Reihenfolge mit drei Stufen, die sich auf der Hardware-Roadmap bereits abzeichnen. Als Beispielfigur dient im folgenden Bild wieder der Neandertaler aus dem Beispielfilm.
Heute stehen KI-Filmwerkzeuge im Mittelpunkt: Cloud-Rendering in Minuten bis Stunden, hohe Ausgabequalität, aber keine Echtzeit. Ihr Wert liegt in Film, Werbung und Markeninhalten. In den Jahren 2026 bis 2027 folgen vorab erfasste Avatare. Neuronale Kopf-Avatare und vortrainierte Figurenmodelle laufen mit über 60 Bildern pro Sekunde auf aktuellen iPhone- und Brillen-Systemen, etwa PrismAvatar oder Meta SqueezeMe.[12][13] Das ist Echtzeit, aber die Figur ist festgelegt und reagiert nicht generativ auf die Umgebung. In den Jahren 2028 bis 2030 könnten generative Echtzeit-Figuren folgen, die sich selbst erzeugen und auf ihre Umgebung reagieren, vorausgesetzt, die oben genannten Bedingungen sind erfüllt.
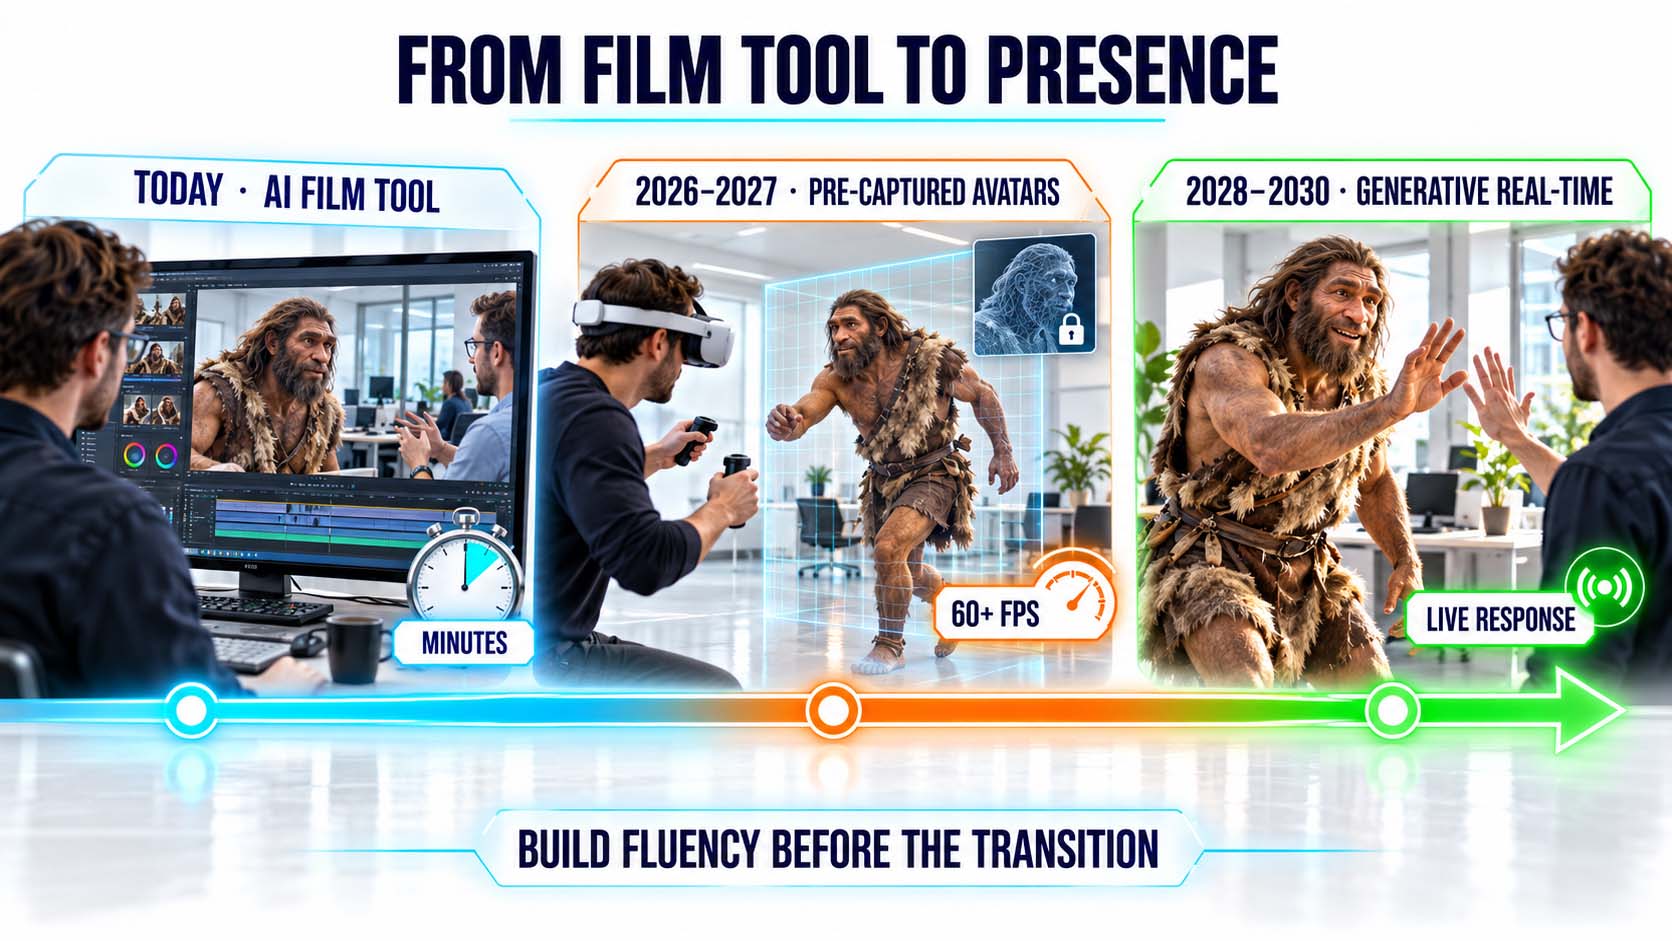
Drei Stufen führen von Minuten Wartezeit zur Live-Reaktion, die Zeit dazwischen ist ein Vorbereitungsfenster.
Infografik: Von heutigen KI-Filmwerkzeugen über vorab erfasste Avatare zu generativen Echtzeit-Figuren, Jahre sind Erwartungen und keine Zusagen[12][13] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
| Stufe | Was möglich ist | Einschränkung |
|---|---|---|
| Heute, KI-Filmwerkzeuge | Cloud-Rendering mit hoher Qualität für Film, Werbung und Markeninhalte | Minuten bis Stunden, keine Echtzeit |
| 2026 bis 2027, vorab erfasste Avatare | Neuronale Avatare mit über 60 Bildern pro Sekunde auf aktueller Hardware | Figur ist festgelegt, nicht generativ |
| 2028 bis 2030, generative Echtzeit | Figuren, die sich erzeugen und live auf die Umgebung reagieren | Bedingt durch 300 bis 500 TOPS, komprimierte 3D-Modelle und gelöste Neubeleuchtung |
Jede Stufe hat eine eigene Einschränkung, die erst die nächste Stufe aufhebt.
Tabelle: Drei Entwicklungsstufen mit Möglichkeiten und Einschränkungen, Zeiträume sind Erwartungen[12][13] | XR Stager Online Magazin | VISORIC GmbH
Für Produktionsteams und Markenverantwortliche ergibt sich daraus eine strategische, keine technische Frage: Auf welchem Teil der Kurve möchte man stehen, wenn der Übergang stattfindet? Teams, die heute Erfahrung mit KI-Compositing sammeln, bauen Produktionsabläufe, Inhaltsbibliotheken und Wissen auf, das sich später direkt auf Echtzeit-Spatial-Computing übertragen lässt. Die Lücke zwischen heutigen Werkzeugen und künftiger Fähigkeit ist ein Vorbereitungsfenster, keine Wartezeit.
- Heute liefern KI-Filmwerkzeuge hohe Qualität mit Wartezeit von Minuten bis Stunden.
- 2026 bis 2027 laufen vorab erfasste Avatare mit über 60 Bildern pro Sekunde.[12][13]
- 2028 bis 2030 könnten generative Echtzeit-Figuren folgen, unter klaren Bedingungen.
- Aufgebaute Arbeitsabläufe und Inhalte lassen sich später auf Echtzeit übertragen.
- Die Zeit bis dahin ist ein Vorbereitungsfenster.
Wie ein solcher Film in Bewegung wirkt, zeigt das folgende Video.
Das Demonstrationsvideo in Bewegung
Die vorangegangenen Kapitel haben erklärt, wie KI-Compositing funktioniert, wo die Grenzen der Echtzeit liegen und wie der Weg dorthin aussehen könnte. Wie das Ergebnis tatsächlich wirkt, lässt sich am unmittelbarsten im Film beobachten.
Das folgende Video stammt vom Creator Divesh Naidoo und zeigt die Technologie Simulon, ein Werkzeug für KI-Compositing mit Reality-Aware Rendering, das Kapitel 2 beschrieben hat. Der Clip dauert 49 Sekunden. Ein Standbild des zugehörigen Beitrags zeigt ein Mammut auf einem Büroschreibtisch neben Tastatur und Glas, darunter ist eine Person im Büro zu sehen. Auf den ersten Blick wirkt das wie eine Augmented-Reality-Figur, die live und intelligent auf einen echten Menschen reagiert.[15]
Der Ablauf dahinter folgt dem Prinzip aus Kapitel 2. Der Creator nimmt eine geplante Szene auf. Simulon verarbeitet anschließend Bewegung, Sprache, Beleuchtung und Umgebung und erzeugt daraus eine neue Figurendarstellung, die zum aufgenommenen Material passt.[1] Die Figur entsteht also nach der Aufnahme und nicht während des Drehs.
Beim Anschauen lohnt sich ein Blick auf vier Dinge: wie das Licht der Figur zur Umgebung passt, ob Schatten und Kontakt mit Objekten glaubwürdig wirken, ob Größe und Perspektive über alle Einstellungen hinweg stimmen und wie die Figur auf die Bewegungen und Worte der Person reagiert. Aussagen über Verarbeitungszeit oder technischen Ablauf lassen sich aus dem Video allein nicht ableiten, diese Angaben stammen aus der Dokumentation des Herstellers.[1]
Video: KI-Compositing-Demo von Divesh Naidoo mit der Technologie Simulon[1][15] | Visuals by original creators | Analysis by Ulrich Buckenlei | XR Stager Online Magazin | VISORIC GmbH
Auffällig ist, wie gut sich die Figur in die Szene einfügt. Das ist eine redaktionelle Beobachtung, kein Nachweis für Echtzeitfähigkeit. Der Clip ist ein fertiger Film, der nach der Aufnahme erzeugt wurde. Die Figur reagiert nicht live auf die Person oder die Umgebung, während die Szene gedreht wird.
Warum das heute nicht anders geht, zeigt die Latenz. Cloud-Rendering liefert erhebliche Rechenleistung, aber Szenendaten zu senden und das Ergebnis zurückzuerhalten kostet Zeit. Reaktionsfähige AR braucht eine vollständige Interaktionsschleife, die deutlich unter einer Sekunde arbeitet, idealerweise unter etwa 100 Millisekunden. Diese Angabe beschreibt die gesamte Schleife aus Wahrnehmen, Entscheiden, Animieren und Darstellen. Für die reine Bildausgabe gilt ein noch deutlich strengerer Wert von 7 bis 15 Millisekunden, wie Kapitel 4 gezeigt hat.
Hinzu kommt die Aufgabe selbst. Eine lebendige KI-Figur muss die Person, den Raum, die Bewegung und den Kontext verstehen, während sie sich verändern. Sie muss entscheiden, wie sie antwortet, diese Antwort animieren und im selben Interaktionsfenster darstellen. Jede dieser vier Stufen, Szenenverständnis, Antworterzeugung, Animation und Rendering, kann zum Engpass werden.
Der Weg nach vorn führt über Edge-KI, kleinere Modelle und dedizierte Hardware für Spatial Computing, die diese Lücke Schritt für Schritt schließen. Das Ziel ist eine KI-Figur, die wahrnehmen, reagieren und im Raum um uns überzeugend präsent bleiben kann. Schon heute ist die Technik ein leistungsfähiges Werkzeug für die Filmproduktion. Der nächste Sprung besteht darin, die Figur wirklich präsent zu machen.
- Das Video stammt vom Creator Divesh Naidoo, die eingesetzte Technologie heißt Simulon.[1][15]
- Der Clip ist ein fertiger Film, der nach der Aufnahme erzeugt wurde, keine Live-AR.
- Achten sollte man auf Licht, Schatten, Objektkontakt, Größe, Perspektive und die Reaktion der Figur.
- Reaktionsfähige AR braucht eine Interaktionsschleife unter etwa 100 Millisekunden, die Bildausgabe allein 7 bis 15 Millisekunden.
- Edge-KI, kleinere Modelle und dedizierte Hardware sollen die Lücke schrittweise schließen.
Dieses Beispiel macht greifbar, warum der Weg vom Film zur Echtzeit-Präsenz Vorbereitung braucht.
Vom Verständnis zur Vorbereitung
Wer KI-Compositing und Echtzeit-AR richtig einordnet, kann Entscheidungen treffen, die heute Nutzen bringen und zugleich auf kommende Fähigkeiten vorbereiten. Das verlangt eine nüchterne Prüfung der Werkzeuge gegen die eigenen Anforderungen: Welche Aufgabe soll gelöst werden, wie viel Zeitverzug ist akzeptabel, und welche Inhalte lassen sich später weiterverwenden?
Das Expertenteam der VISORIC GmbH aus München berät Industrie und B2B-Unternehmen seit über 15 Jahren zu 3D-Visualisierung, VR/XR-Anwendungen und Spatial Computing. Es verbindet technische Tiefe mit Produktionserfahrung: von interaktiven 3D-Plattformen und VR-Trainingsumgebungen bis zu KI-gestützter Inhaltsproduktion und Strategien für Spatial Computing.[16][17]
15 Jahre Erfahrung in 3D, KI und XR: das VISORIC Expertenteam aus München.
Bild: © Ulrich Buckenlei | XR Stager Online Magazin | VISORIC GmbH
Ein einzelner, klar abgegrenzter Anwendungsfall lässt sich oft deutlich schneller und kostengünstiger umsetzen, als viele Unternehmen erwarten.
- Einordnung von KI-Compositing-Werkzeugen gegen reale Produktionsanforderungen.
- Aufbau von Abläufen und Inhalten, die später in Echtzeit-Spatial-Computing weiterverwendet werden können.
- Umsetzungs-Roadmaps, die heute Nutzen liefern und auf kommende Fähigkeiten vorbereiten.
Genau darin liegt der Ausgangspunkt für ein Gespräch: nicht bei der großen Vision, sondern bei der Frage, welcher erste Schritt heute sinnvoll ist.
Auf welchem Teil der Kurve möchte Ihre Organisation stehen, wenn der Übergang zur Echtzeit stattfindet?
Sprechen Sie mit dem VISORIC Expertenteam aus München über KI-gestützte Inhaltsproduktion, Spatial Computing und digitale Zwillinge. Gemeinsam entwickeln wir aus Ihrer Aufgabe einen präzisen, nachvollziehbaren nächsten Schritt.
Kontakt:
E-Mail: info@visoric.com
Telefon: +49 89 21552678
Quellen und Referenzen
- Simulon. Reality-Aware Rendering, Dokumentation und Produktseite, Herstellerangaben. simulon.ai.
- Autodesk. Flow Studio (früher Wonder Studio), Herstellerdokumentation. autodesk.com/flow-studio.
- Move.ai. Markerlose Bewegungserfassung, Produktseite, Herstellerangaben. move.ai.
- Epic Games. MetaHuman Animator, Dokumentation. dev.epicgames.com.
- Adobe. Firefly Video, Herstellerangaben. adobe.com/firefly/features/video.
- Mobile-GS: Efficient Gaussian Splatting for Mobile Devices. CVPR 2025. arxiv.org/abs/2408.08206.
- Kerbl et al. 3D Gaussian Splatting for Real-Time Novel View Synthesis, 2023. repo.cs.univie.ac.at.
- NVIDIA. CloudXR, Dokumentation zur Latenz, Herstellerangaben. developer.nvidia.com/cloudxr-sdk.
- 3GPP. TR 22.872, Study on AR/VR requirements. 3gpp.org.
- Apple. M5 Neural Engine, Architekturhinweise, Herstellerangaben. developer.apple.com.
- Qualcomm. Snapdragon X Elite, Whitepaper zur KI-Leistung, Herstellerangaben. qualcomm.com.
- PrismAvatar. Real-time neural head avatar on mobile, Februar 2025.
- Meta. SqueezeMe, photorealistic avatars on Quest 3, 2025.
- Swapratim Roy. LinkedIn-Beitrag zu Simulon, Oktober 2026.
- Divesh Naidoo. Produktdemonstration als Video zu Simulon, 2026.
- VISORIC Praxisprojekte in den Bereichen 3D-Visualisierung, VR/XR und Spatial Computing.
- XR Stager Plattform für Echtzeit-3D, digitale Zwillinge und industrielle Spatial-Computing-Anwendungen.
Kontaktpersonen:
Ulrich Buckenlei (Kreativdirektor)
Mobil: +49 152 53532871
E-Mail: ulrich.buckenlei@visoric.com
Nataliya Daniltseva (Projektleiterin)
Mobil: + 49 176 72805705
E-Mail: nataliya.daniltseva@visoric.com
Adresse:
VISORIC GmbH
Bayerstraße 13
D-80335 München